PO:部分收货、KM和P90边界
全文共 2033 字,阅读约需 5 分钟
PO:部分收货、KM和P90边界:问题:订购100件,第10天收40件、第15天收30件、第25天收30件。第20天观察,交期是不是15天?
课程目录与学习记录 0 / 109
学习进度仅存于本机浏览器。原教程站的记录不会跨域自动迁移;可先在原站导出留存,新站按实际完成情况重新勾选。
入门数据与作业包
禾味数据为 2 店 × 8 SKU × 180 天,共 2,880 行,是可见教学数据,不是封存盲测集。起步包是模拟夹具,不表示已完成六行业预测实验。资源中心另有四专项工程、模型实验和计划实验,使用前请阅读各自能力边界。
完全模拟的可复现实验,不连接生产。下载四专项完整工程包(20,000/12,000/10,000/2,000实体)。运行前阅读覆盖data/outputs的说明。固定模拟世界的指标不是企业收益。
练习4:一张PO分三次到货
问题:订购100件,第10天收40件、第15天收30件、第25天收30件。第20天观察,交期是不是15天?
- 第20天已收70、未收30,尚未收齐。完成时长未知,随访20天,右删失=1。第25天才有“收齐时长25天”的标签。
- 在
po/training_labels_asof179.csv找一条censored=1。核对订购=已收+未收;complete_age必须为空。 - 打开
po/test_po_predictions.csv,查看P90留空的行。为何“空”比随便填最大历史天数更诚实? - 打开
po/coverage_bounds.csv,把有预测条数/全部条数写出来。覆盖上下界不等于置信区间,也不能只报好看的子集。 - 对比固定交期、只看完成样本、KM。解释为什么只看已经收齐的PO容易漏掉慢单。
交付:一个部分收货账、至少一个未完成标签说明、一份含分母和上下界的P90报告。
手算答案:第20天完成时长未知;第25天收齐时长25天,不是首收10天或第二收15天。
验收:所有日期的订购=已收+未收;未收不为负;右删失不记为交期0;不可估计P90留空;不因模型结果自动改真实PO。
统一提交清单
- 命令与Python版本。
- 固定种子、数据规模、训练/验证/测试日期和标签截止日。
- 与同样样本基线的对比,包含失败或退步的结果。
- 一项手算、一项守恒检查、一项未来信息检查。
- 未实现模型与不能推广的条件。
先完成这五项,再考虑更复杂算法。复杂名称不能替代正确的时间和账本。
模型实现及未实现范围
D. PO部分收货与收齐交期
实现:10供应商、20物料;部分收货事件与未收齐数量;下单时预测完整收齐日龄;固定P50=21日/P90=35日规则基线;只看已完成PO的经验分位数(作为有偏对照);总体/供应商Kaplan–Meier;按验证集30天内收齐Brier选择;P50/P90预测、不可估计尾部留空、覆盖率上下界、已完成样本pinball诊断。
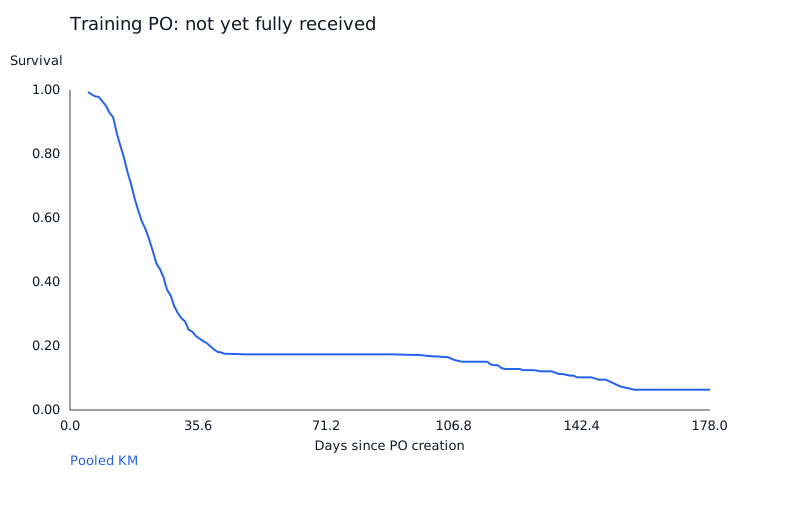
同一天先完成事件再行政删失。分位数定义为KM累计收齐概率第一次达到目标的日龄。若曲线未达到90%,不返回最大观察天数冒充P90。
关键假设:行政观察截止与未来收齐时间在分组条件下可比/独立。模拟创建日期独立于交期,且没有额外时间漂移;现实采购旺季、催单、供应商替换会破坏这种可比性。
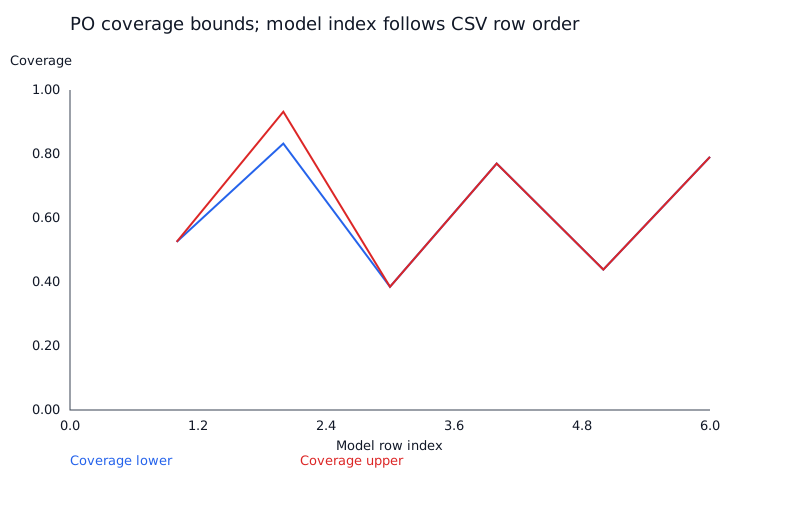
覆盖率上下界:已经在预测日以内收齐的肯定覆盖;仍未收齐但已经观察到预测日的肯定不覆盖;观察不足预测日的暂不确定。它们不是置信区间。只对有可估计预测的样本计算,并同步披露分母,不能将其推广到空值PO。
未实现:参数生存模型、分位数回归、AFT、随机森林、梯度提升、供应商层级贝叶斯模型、物料交互、多状态到货过程预测、缺量取消、延期变更、催单策略、需求与交期相关场景安全库存、端到端补货优化。这里完整实现的是数据、透明基线和评估,不把上述模型列成已交付。
结论怎么写才诚实
可以写:“在固定模拟机制、指定时间分块及所列假设下,方法A的某指标为x,与同样样本上的基线y相比……”
不可以写:“因此真实企业必降库存20%”“P90一定覆盖90%”“训练完校准必定更准”“测试通过就能自动下单”“大量模拟数据证明不存在因果偏差”。
实际运行结果与解释
4. PO:不确定的P90就留空
- 测试335条PO,截止时49条未收齐;训练截止时60条未收齐。
- 验证集按30天内收齐Brier选择supplier KM。P50覆盖率52.54%,目标50%。
- P90可估计221/335条,不可估计114条,必须披露这个分母。可估计部分的实际覆盖率界为83.26%–93.21%;其中22条观察不足以判定。P90留空原因是训练KM曲线未达到90%收齐概率;没有可估计预测时不报告覆盖率,不用0或最大观察日填补。这个区间不是统计置信区间。
- 只用已完成训练PO的朴素P90,在全测试集覆盖79.10%,低于目标90%。若训练没有已完成PO,该分位数与覆盖率均不可估计。
- 没有统一“最好模型”结论:覆盖只对有可估计预测的样本描述;仅已完成样本的pinball有选择偏差风险。
查看:po/test_po_predictions.csv、po/coverage_bounds.csv、po/km_survival.svg。
验证记录
运行命令:python run_all.py。测试的实际通过/失败与运行时间以
test_results.txt、run_log.txt 为准。生成清单在
../data/manifest.json。脚本重跑时会重写本页;本页没有把任何未运行模型列成已完成。
仅保存在本机当前浏览器,无账号云同步;清除浏览器数据会丢失。不自动认定你通过测试。建议先保留输出文件和计算过程。
所有数据、系数与业务场景均为教学模拟。预测不等于采购或排产指令。来源与修订说明。