预测之前,先把问题与数据说清楚
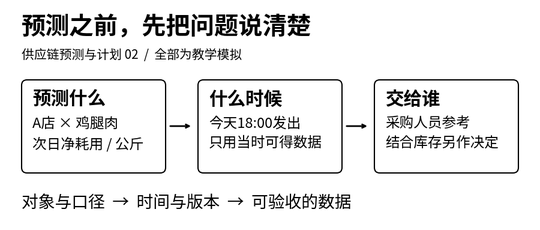
预测明天的销量,究竟指份数、食材公斤数,还是采购量?用虚构禾味两店8个SKU的14天记录与匿名服装订单事件,把目标、单位、时间粒度和信息截止点写成可验收的任务。通过手算、224行模拟数据及标准库实践,区分迟到数据、未来版本、缺失与缺货,为后续回归和时间序列建模建立共同的数据起点。
继续阅读 →从OTIF到库存指标 一套可复核的供应链指标字典
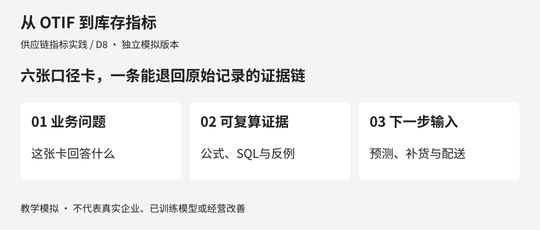
报表上的履约率、缺货率和库存周转,怎样才能支持同一次业务讨论?本文把六张口径卡整理成可复核的指标字典,用禾味两店八食材的模拟数据核对三项SQL,再用匿名服装协同账本区分周转、覆盖和损耗。每个结果都保留分子、分母、时间和数据边界,并列出预测、补货与配送下一步真正需要补齐的输入。
继续阅读 →删掉异常后满足率更高了 把数据问题与业务表现分开
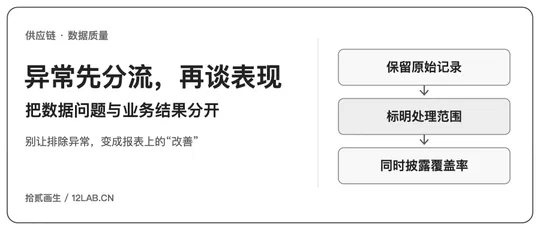
把异常记录排除,满足率从70%升到93.33%,就能说明履约改善吗?本文用匿名服装生产与虚构禾味门店的模拟数据,区分重复上报与合法分批验收、零库存与未知快照,逐条界定阻断、披露排除和待确认范围。结合可执行SQL、覆盖率和同分子对照,保留原始记录与处理证据,帮助读者判断更好看的指标来自业务变化,还是评价人群改变。
继续阅读 →